De vraag van de AFM lijkt op het eerste gezicht een communicatievraag. Leg persoonlijk, duidelijk en evenwichtig uit waarom een bedrag hoger of lager is geworden. Voor mij begint dat bij de berekening eronder.
Eerst rekenen. Daarna reconciliëren. Pas daarna verklaren.
Niet automatisch een mooie tekst laten maken, maar eerst aantonen welke wijziging welk deel van het verschil veroorzaakt.
Want een persoonlijke toelichting begint niet bij tekst, maar bij de vraag of je het verschil tussen beide berekeningen reproduceerbaar kunt verklaren.
De aanleiding: twee overzichten en een verschil
De AFM onderzoekt de definitieve transitieoverzichten van pensioenuitvoerders die begin 2026 zijn ingevaren. Daarbij kijkt zij nadrukkelijk naar de wettelijk verplichte toelichting op verschillen tussen het prognose- en definitieve transitieoverzicht.
Die toelichting moet volgens de AFM aansluiten bij de deelnemer. Niet alleen gewijzigde economische omstandigheden kunnen relevant zijn. Ook veranderingen in de persoonlijke situatie tellen mee. Iemand kan bijvoorbeeld minder zijn gaan werken. De AFM noemt daarnaast het voorbeeld van een lager individueel pensioenkapitaal terwijl de dekkingsgraad is gestegen.
De AFM schrijft geen technische oplossing voor. De rekenopzet in deze bouwblog is mijn praktische vertaling van het vraagstuk.
Wat ik onder brief 1 en brief 2 versta
Brief 1 is het prognose-transitieoverzicht. De beschikbare deelnemersstand ligt vaak vóór de transitiedatum. Daardoor is niet alleen de peildatum van belang, maar ook de manier waarop die stand naar de transitiedatum wordt geprojecteerd.
Brief 2 is het definitieve transitieoverzicht. Daarin worden de definitief vastgestelde bedragen getoond op basis van de actuele situatie en de uitgangspunten die voor die tweede berekening gelden.
Tussen beide momenten kunnen het salaris, deeltijdpercentage, de deelnemersstatus, premie, het startkapitaal, de financiële positie en de gebruikte scenarioset zijn gewijzigd. Het bedrag in brief 2 kan dus om meerdere redenen afwijken van brief 1.
Waarom “het bedrag is veranderd” niet genoeg is
Een generieke tekst dat bedragen kunnen veranderen, helpt een deelnemer niet om zijn eigen verschil te begrijpen. Maar de andere uiterste oplossing, per deelnemer vrij een verklaring laten schrijven, vind ik evenmin verstandig.
De berekening moet eerst laten zien welke factoren daadwerkelijk relevant zijn. Pas daarna kan een vooraf beoordeeld tekstblok worden gekozen. Dat sluit aan bij de conditionele aanpak uit het inspiratiedocument van de Pensioenfederatie: teksten worden getoond wanneer aan vooraf bepaalde voorwaarden is voldaan.
Twee snapshots van dezelfde fictieve deelnemer
Mijn werkhypothese is eenvoudig: leg de invoer en uitkomsten van beide berekeningen vast en match ze op een intern deelnemer-id. Maar de eerste snapshot is niet simpelweg de oude deelnemersstand.
Bij brief 1 gebruiken we de beschikbare deelnemersgegevens vóór de transitie en brengen we die volgens de gehanteerde uitgangspunten naar de transitiedatum. Brief 2 begint juist bij de actuele werkelijkheid na de transitie. Daarmee vergelijken we dus niet simpelweg twee bestanden: we vergelijken een eerdere prognose met een later vastgestelde situatie. De pessimistische, verwachte en optimistische uitkomsten moeten daarbij afzonderlijk worden gevolgd.
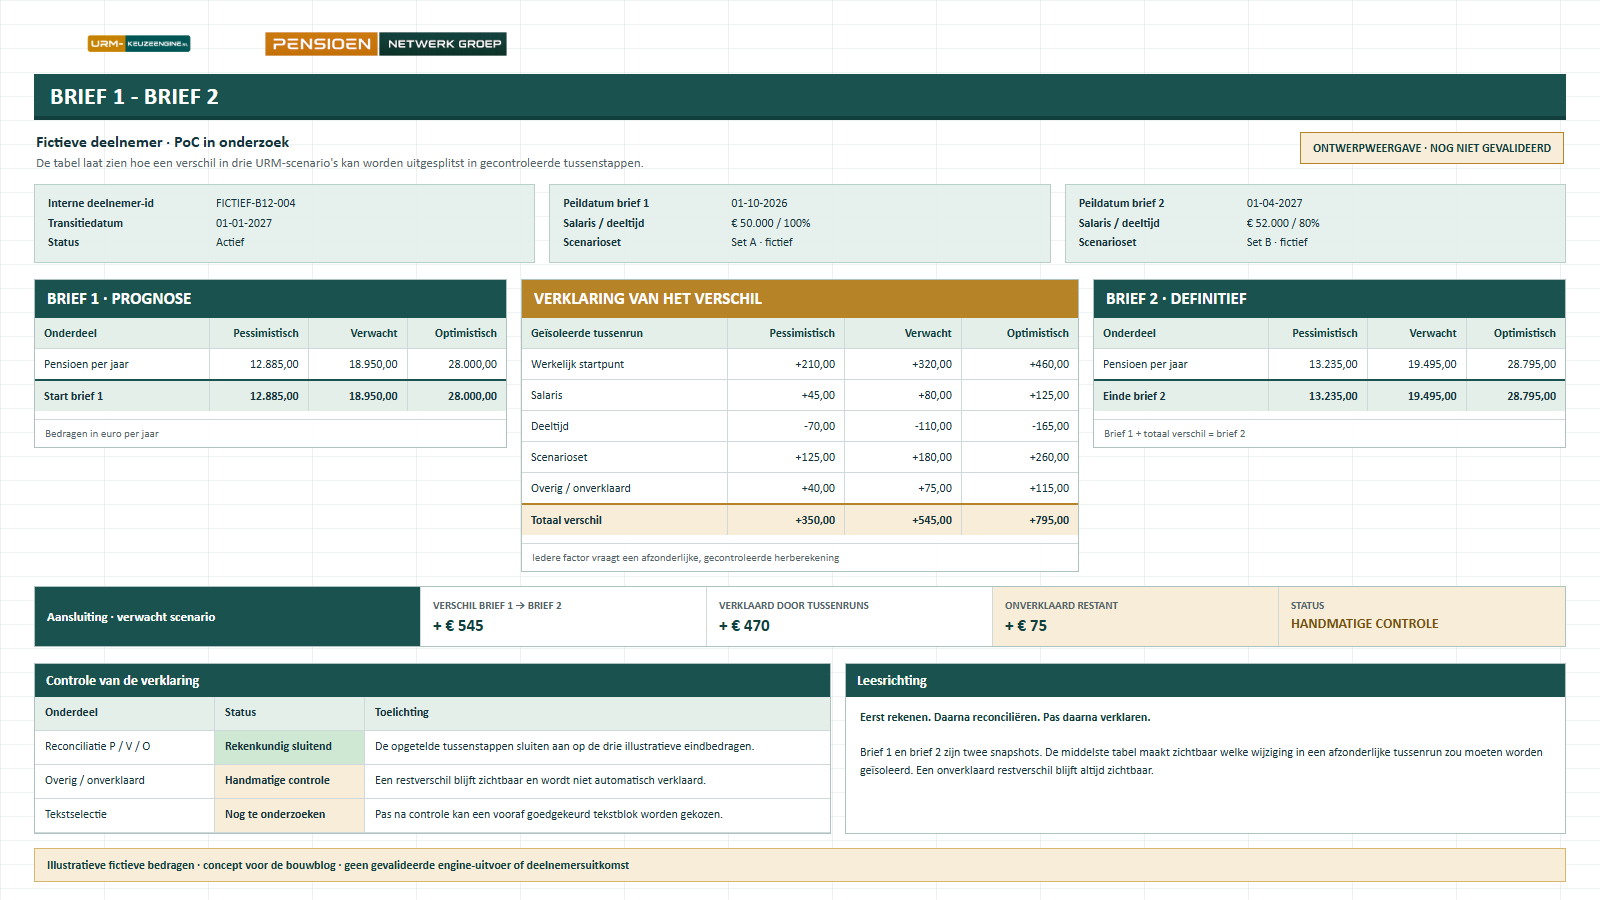
Daarna wijzig je niet alles tegelijk. Je maakt gecontroleerde tussenruns: eerst het werkelijke startpunt, vervolgens bijvoorbeeld salaris, deeltijd, deelnemersstatus en scenarioset. Alleen wanneer een factor afzonderlijk is doorgerekend, mag het verschil aan die factor worden toegeschreven.
Wat de URM-KeuzeEngine al kan
De huidige KeuzeEngine heeft al een deel van de benodigde bouwstenen. In Excel kan ik een huidige en een optionele nieuwe situatie invoeren. Status, salaris, deeltijd, grondslag en profiel kunnen daarbij wijzigen. De uitkomst toont de drie URM-scenario's en zet situaties en verschillen naast elkaar.
De engine kan daarnaast JSON- en CSV-uitvoer opslaan, een groep fictieve deelnemers via CSV doorrekenen en op het validatieblad een rekenbon tonen. Dat maakt de kern bruikbaar onder verschillende schermen en toepassingen.
Er is ook een belangrijke beperking. Bij een latere peildatum gebruikt de huidige proefversie een benaderd startkapitaal op het verwachte scenario, tenzij zelf een bedrag wordt ingevuld. De snelstart vermeldt uitdrukkelijk dat dit geen exacte tweetrapsprojectie is. Voor brief 1 naar brief 2 moet juist die aansluiting eerst goed worden ontworpen en getest.
Excel als cockpit, niet als nieuwe rekenengine
Ik wil de rekenlogica niet nog een keer in Excel bouwen. Excel is hier de cockpit: invoer controleren, snapshots tonen, tussenruns starten en de aansluiting beoordelen. De bestaande headless engine blijft rekenen.
Dat voorkomt twee versies van dezelfde logica. Het maakt ook batchverwerking mogelijk zonder dat iedere berekening handmatig in een werkblad hoeft te worden uitgevoerd.
Zo zou de reconciliatie kunnen werken
- Leg de invoer, peildatum, grondslagen en P/V/O-uitkomsten van brief 1 vast.
- Leg dezelfde gegevens voor brief 2 vast en controleer of dezelfde fictieve deelnemer wordt vergeleken.
- Maak per mogelijke verklaringsfactor één gecontroleerde tussenrun.
- Tel de geïsoleerde effecten op en sluit ze afzonderlijk aan op pessimistisch, verwacht en optimistisch.
- Laat ieder resterend verschil zichtbaar als overig/onverklaard en stuur dat naar handmatige controle.
Persoonlijk zonder voor iedere deelnemer tekst te schrijven
Na de berekening kan een beperkte regelset bepalen welke vooraf goedgekeurde tekstcode past. Denk aan SALARIS_HOGER, PARTTIME_LAGER, ACTIEF_NAAR_SLAPER of SCENARIOSET_GEWIJZIGD.
Dat ligt dicht bij de aanpak van de Pensioenfederatie. Het inspiratiedocument beschrijft conditionele tekstblokken op basis van vooraf vastgestelde regels en vergelijkt die werkwijze zelf met als-dan-programmeren. Ik probeer dus geen vrije AI-uitleg te bedenken, maar een bestaande communicatiemethodiek technisch reproduceerbaar te maken.
De conditie moet niet alleen naar de mutatie kijken, maar ook naar het berekende effect. Als iemand parttime is gaan werken, maar dat verschil niet correct is geïsoleerd, hoort de engine niet te doen alsof deeltijd de verklaring is.
Vrij gegenereerde AI-tekst is voor mij daarom niet de primaire verklaring. De combinatie van gecontroleerde factoren, voorwaarden en tekstblokken moet reproduceerbaar zijn. Daarna kunnen begrijpelijkheid en samenhang met maatmensen worden getest.
Van één deelnemer naar een batch
Dezelfde opzet moet uiteindelijk ook voor een fictieve testgroep werken. Per deelnemer leg je de uitkomsten van beide berekeningen, de gevonden factoren, hun effecten en het onverklaarde restverschil vast.
Een controle-uitvoer kan vervolgens tellen hoeveel dossiers volledig aansluiten, hoeveel een restverschil hebben en hoeveel handmatige beoordeling vragen. Materialiteitsgrenzen zijn daarbij nog een ontwerpbesluit, geen wettelijke norm die ik zelf kan invullen.
Wat deze eerste bouwopzet laat zien
Huidige en nieuwe situatie, drie URM-scenario's, verschilweergave, rekenbon, JSON/CSV en batchverwerking met fictieve gegevens.
Exacte projectie naar de transitiedatum, historische grondslagen, afzonderlijke tussenruns, volledige aansluiting en gevalideerde tekstselectie. Ook de volgorde waarin factoren worden gewijzigd kan invloed hebben op de toegerekende delta. Dat moet onderdeel zijn van de toets.
De technische richting lijkt bruikbaar, juist omdat de engine al wijzigingen en verschillen kan doorrekenen. Maar dat is nog geen bewijs dat de volledige Brief 1→Brief 2-keten actuarieel en communicatief klopt.
Wat ik als volgende wil toetsen
De eerste proef moet beginnen met vier overzichtelijke fictieve gevallen: alleen een salariswijziging, alleen parttime, actief naar slaper en een combinatie met een ander startpunt en een andere scenarioset.
Daarbij wil ik per scenario kunnen aanwijzen waar ieder bedrag vandaan komt, welk deel nog niet verklaard is en welke controle nodig blijft. Pas daarna is het zinvol om tekstcodes of een grotere batch toe te voegen.
Meedenken vanuit de pensioenpraktijk
Werk je aan transitieoverzichten, deelnemerscommunicatie, actuariële controles of pensioenadministratie? Dan hoor ik graag welke verschillen in de praktijk het lastigst reproduceerbaar zijn. Juist de gevallen waarin twee plausibele berekeningen toch niet aansluiten, zijn voor deze bouwproef interessant.
Zelf met de rekenkern testen?
De URM-KeuzeEngine is momenteel in bèta bij een beperkte groep pensioenprofessionals. Ik ben vooral benieuwd of deze toepassing rond brief 1 en brief 2 in de praktijk herkenbaar en bruikbaar is. Gebruik tijdens de proef uitsluitend fictieve gegevens.
Bekijk de URM-KeuzeEngineBronnen en afbakening
- AFM, “Geef persoonlijke toelichting op verschil prognose en definitief transitieoverzicht”, 15 september 2026.
- Pensioenfederatie, “Transitiecommunicatie: aanpak uitleg verschillen”, 12 mei 2025.
De bronnen beschrijven verwachtingen en inspiratie voor de communicatie. Zij schrijven de hier getoonde technische rekenopzet niet voor. De PoC-opzet en interpretatie zijn van PensioenNetwerk.nl.